

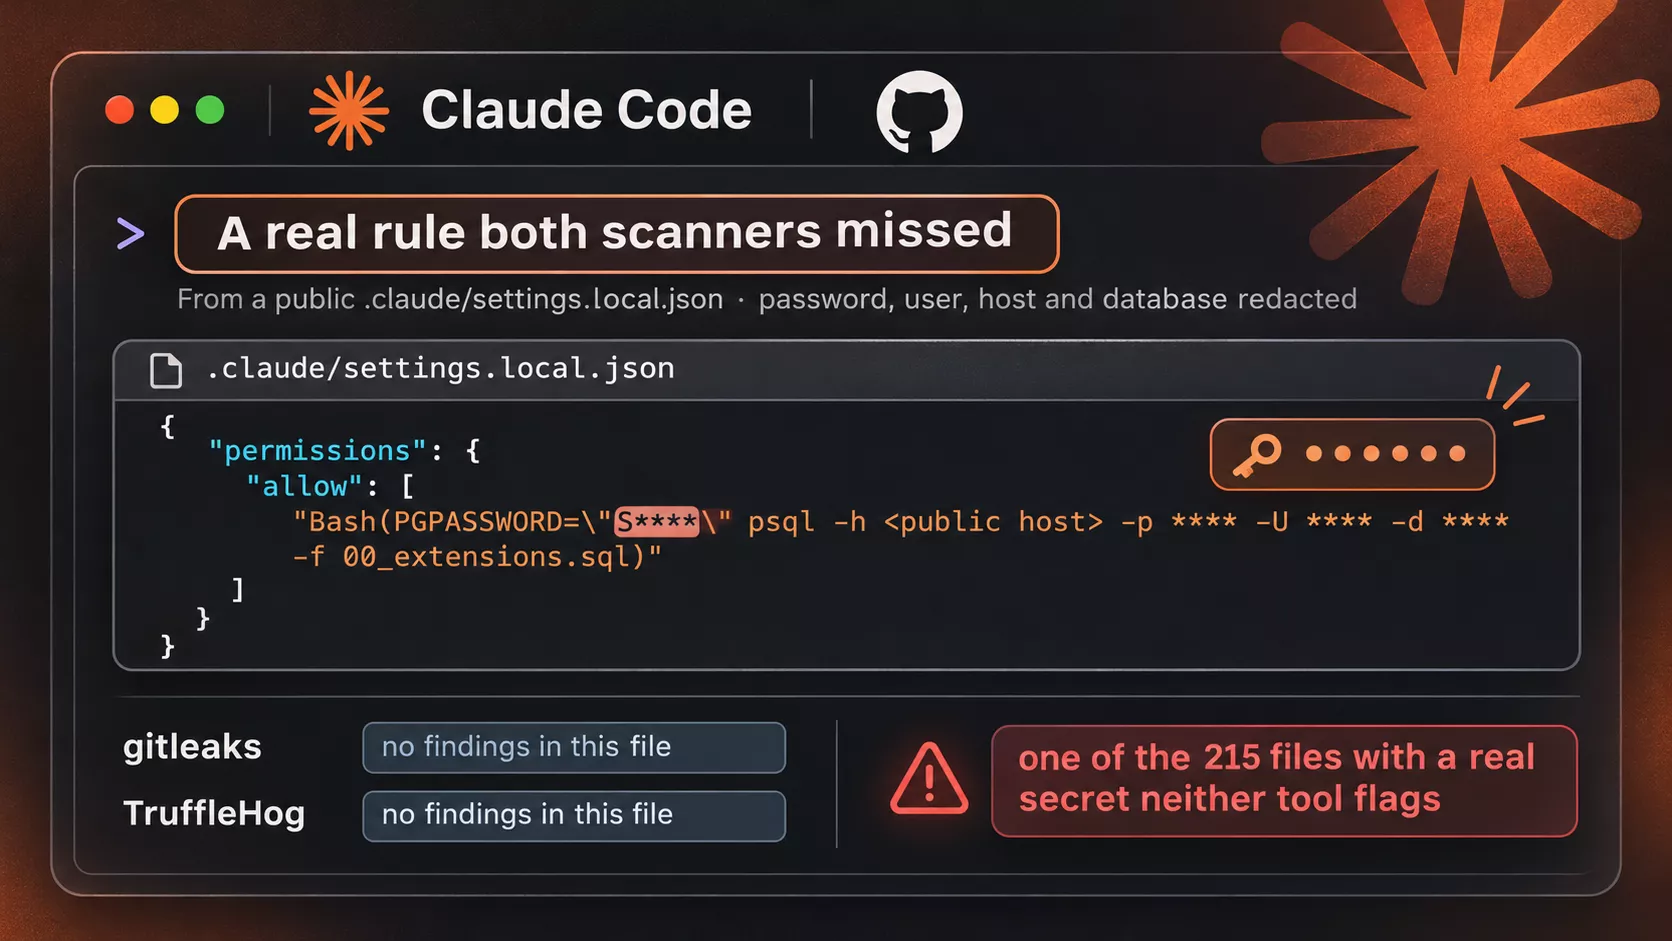


Un mécanisme destiné à simplifier le travail des développeurs soulève des inquiétudes en matière de cybersécurité. La fonctionnalité « Oui, et ne plus demander » de Claude Code peut enregistrer des commandes contenant des identifiants sensibles dans des fichiers de configuration locaux. Lorsque ces fichiers sont publiés sur GitHub, les informations confidentielles deviennent accessibles publiquement.
Dans une étude publiée le 5 novembre 2026, les chercheurs Shmulik Cohen et Matan Giladi, de l’entreprise de cybersécurité Apiiro, ont identifié 2 539 secrets distincts répartis dans 1 994 dépôts GitHub publics. Les données exposées comprennent notamment des mots de passe de bases de données, des clés d’accès cloud, des jetons API et des identifiants SSH.
Cette découverte met en évidence un risque lié à l’utilisation des assistants de programmation basés sur l’intelligence artificielle. Elle rappelle également que les fichiers générés automatiquement doivent bénéficier des mêmes contrôles de sécurité que le code source.
Une fonctionnalité de Claude Code à l’origine de l’exposition
Claude Code est un outil développé par Anthropic. Il permet aux développeurs d’interagir avec un agent d’intelligence artificielle capable d’exécuter des commandes, de modifier des fichiers et d’effectuer différentes tâches dans un environnement de développement.
Pour encadrer ces opérations, l’outil demande généralement une autorisation avant d’exécuter certaines commandes dans le terminal. L’utilisateur peut alors choisir une autorisation ponctuelle ou sélectionner l’option « Oui, et ne plus demander ».
Cette seconde option permet de mémoriser une autorisation afin d’éviter les demandes répétées. Toutefois, le fonctionnement de ce mécanisme présente un risque lorsque la commande approuvée contient directement des informations confidentielles.
En effet, Claude Code peut enregistrer la commande approuvée dans le fichier .claude/settings.local.json, sous forme de règle d’autorisation. Si le développeur saisit un mot de passe ou un jeton directement dans la commande, cette information peut également être conservée dans le fichier.
Par exemple, une commande contenant un mot de passe de base de données peut laisser apparaître cet identifiant dans une règle enregistrée. Le problème ne provient donc pas nécessairement d’une attaque contre l’intelligence artificielle, mais de la manière dont certaines autorisations sont sauvegardées.
La documentation consacrée aux fichiers de configuration de Claude Code décrit les différents emplacements utilisés pour stocker ces paramètres.
2 539 secrets identifiés dans près de 2 000 dépôts publics
Les résultats de l’étude d’Apiiro révèlent une exposition plus importante que celle visible dans les seuls fichiers de configuration actuels.
Les chercheurs ont examiné 104 185 copies du fichier .claude/settings.local.json, réparties dans 103 617 dépôts publics. Parmi elles, 1 122 fichiers contenaient au moins un secret, soit environ 1,1 % des fichiers analysés.
Ces fichiers renfermaient à eux seuls 1 379 secrets distincts. L’analyse a ensuite été élargie à l’historique Git, aux fichiers de configuration partagés et aux transcriptions de conversations enregistrées par des agents de codage.
Cette approche a porté le bilan à 2 539 secrets distincts dans 1 994 dépôts GitHub publics.
Les chercheurs ont notamment identifié plusieurs catégories d’informations sensibles :
- Mots de passe de bases de données : 379 identifiants permettant potentiellement d’accéder à des environnements de données.
- Identifiants SSH : 43 accès associés à des serveurs publics.
- Jetons GitHub, GitLab et npm : 42 jetons susceptibles de donner accès à des ressources de développement.
- Clés AWS : 23 identifiants associés à l’infrastructure cloud.
- Autres secrets : clés de services cloud, jetons d’API et identifiants de différentes plateformes.
L’étude mentionne également des cas particulièrement sensibles. Parmi eux figurent une clé cloud disposant de privilèges administratifs, un mot de passe associé à une base PostgreSQL de production et des identifiants liés à une base de données médicales.
Au total, 63 organisations seraient concernées par les expositions recensées. Il s’agit principalement d’entreprises du secteur logiciel.
L’historique Git prolonge le risque d’exposition
La suppression d’un fichier contenant des identifiants ne garantit pas leur disparition d’un dépôt GitHub.
En effet, Git conserve l’historique des modifications. Lorsqu’un développeur supprime un fichier sensible dans une nouvelle version du projet, les anciennes versions peuvent toujours contenir les informations confidentielles.
Les chercheurs d’Apiiro ont ainsi identifié 734 secrets supplémentaires dans l’historique de 509 dépôts. Ces identifiants n’apparaissaient plus dans les fichiers actuels, mais restaient accessibles dans les anciennes versions.
Les copies de dépôts constituent également un autre point de vigilance. L’étude a recensé 211 forks appartenant à 74 dépôts qui conservaient les mêmes secrets.
Cette situation complique les opérations de nettoyage. Même après la suppression d’un fichier dans le dépôt principal, les informations peuvent subsister dans les historiques et les copies créées par d’autres utilisateurs.
Pour les entreprises, le risque dépasse donc la simple publication accidentelle d’un fichier. Un identifiant exposé peut rester accessible pendant plusieurs mois, voire davantage, sans être détecté.
Les mécanismes de protection ne détectent pas toutes les informations sensibles
L’étude met également en évidence les limites des outils classiques de détection des secrets.
Les chercheurs ont soumis les fichiers analysés à deux solutions connues : Gitleaks et TruffleHog. Ces outils permettent notamment de rechercher des clés API, des jetons d’authentification et d’autres identifiants dans les dépôts de code.
Les résultats montrent toutefois des différences importantes :
| Outil de détection | Fichiers identifiés |
|---|---|
| Gitleaks | 564 |
| TruffleHog | 643 |
| Non détectés par les deux outils | 215 |
Sur les 1 122 fichiers contenant des secrets, 215 n’ont été signalés par aucun des deux outils. Cela représente environ 19,2 % des fichiers concernés.
Cette limite s’explique notamment par la nature des informations exposées. Certains mots de passe sont directement intégrés dans des commandes shell. Ils ne présentent pas nécessairement les formats habituels des clés API ou des jetons reconnus par les scanners.
Une commande contenant un mot de passe de base de données peut donc échapper à certaines règles de détection automatisée.
Ce constat rappelle que les outils de sécurité ne doivent pas être considérés comme une garantie absolue. Les équipes informatiques doivent également examiner les fichiers de configuration, les historiques Git et les données générées par les agents de programmation.
Quelles mesures pour éviter l’exposition des secrets ?
Face à cette situation, les développeurs et les responsables de la sécurité doivent renforcer la gestion des identifiants utilisés pendant les opérations de développement.
Plusieurs mesures permettent de réduire les risques.
1. Éviter d’intégrer les identifiants directement dans les commandes
Les mots de passe et les clés API ne doivent pas apparaître directement dans les commandes exécutées dans le terminal. Il est préférable d’utiliser des variables d’environnement ou un gestionnaire de secrets.
Cette approche limite la présence des informations confidentielles dans les historiques et les fichiers de configuration.
2. Vérifier le fichier .claude/settings.local.json
Les développeurs utilisant Claude Code doivent examiner régulièrement ce fichier. Ils doivent rechercher les mots de passe, les jetons API et les commandes contenant des identifiants.
Il convient également de vérifier les fichiers .claude/settings.json et les autres fichiers produits par les agents de codage.
3. Renforcer les règles du fichier .gitignore
Le fichier .claude/settings.local.json doit être explicitement exclu du suivi Git au niveau du projet.
Cette précaution complète les exclusions globales que Claude Code configure normalement sur la machine de l’utilisateur. Une exclusion globale ne remplace pas une règle propre au dépôt et ne protège pas un fichier déjà suivi par Git.
4. Analyser les historiques des dépôts
La vérification ne doit pas se limiter aux fichiers présents dans la dernière version du projet. Les équipes doivent rechercher les anciennes versions susceptibles de contenir des identifiants exposés.
Des outils comme Gitleaks peuvent contribuer à automatiser cette surveillance.
5. Révoquer et renouveler immédiatement les identifiants exposés
Lorsqu’un secret est découvert dans un dépôt public, sa simple suppression ne suffit pas. Il faut considérer cet identifiant comme compromis.
Les équipes doivent révoquer les jetons concernés, renouveler les mots de passe et vérifier les journaux d’accès. Elles doivent également examiner les éventuelles activités suspectes sur les services associés.
Ces mesures sont particulièrement importantes pour les identifiants donnant accès aux bases de données de production et aux infrastructures cloud.
Une alerte supplémentaire sur la sécurité des assistants de programmation IA
Cette découverte dépasse le seul fonctionnement de Claude Code. Elle soulève une question plus large sur la manière dont les assistants de programmation gèrent les informations sensibles.
Les agents de codage disposent parfois d’autorisations leur permettant de consulter des fichiers, d’exécuter des commandes et de modifier des projets. Leurs fichiers de configuration et leurs historiques peuvent ainsi devenir de nouvelles sources d’exposition.
Un signalement publié sur le dépôt GitHub officiel de Claude Code dès décembre 2025 décrivait déjà la conservation de jetons sensibles dans .claude/settings.local.json et les risques liés à leur intégration dans Git.
Ce signalement montre que le problème avait déjà été soulevé par des utilisateurs avant la publication de l’étude d’Apiiro. Il ne constitue toutefois pas, à lui seul, une confirmation d’une faille de sécurité exploitée à grande échelle.
Il est donc essentiel de considérer les assistants IA comme des composants à intégrer dans les politiques de sécurité des environnements de développement. Le contrôle des permissions, la protection des secrets et la surveillance des modifications doivent également couvrir les fichiers générés par ces outils.
Conclusion
L’exposition de 2 539 secrets dans 1 994 dépôts GitHub publics montre que les fonctionnalités de productivité des assistants de programmation peuvent introduire de nouveaux risques de sécurité.
La fonctionnalité « Oui, et ne plus demander » de Claude Code illustre particulièrement ce problème. Une autorisation accordée pour simplifier le travail peut entraîner la conservation involontaire d’informations confidentielles dans des fichiers susceptibles d’être publiés.
Pour les entreprises, cette découverte rappelle l’importance d’intégrer les outils d’intelligence artificielle dans les politiques de sécurité informatique. La protection des dépôts Git, la gestion des secrets et la surveillance des accès doivent désormais prendre en compte les fichiers générés par les agents IA.
Une chose reste essentielle : un fichier supprimé n’efface pas nécessairement un secret déjà exposé. La révocation et le renouvellement des identifiants doivent donc rester prioritaires.
SOURCE : CybersecurityNews


